

Diagnozowanie maszyn z wykorzystaniem sztucznej inteligencji polega na tym, że algorytmy uczą się normalnej pracy urządzenia na podstawie danych z czujników i historii serwisu, a potem wskazują odchylenia zapowiadające usterkę. Dział utrzymania ruchu dostaje sygnał, zanim maszyna się zatrzyma.
Tak jak lekarz stawia diagnozę na podstawie objawów, AI ocenia stan maszyny na podstawie drgań, temperatury czy prądu silnika. Ten artykuł wyjaśnia, jakimi metodami się to robi, jakie czujniki są potrzebne i jaką rolę pełni system CMMS, który zamienia alert w zaplanowaną naprawę.
Jak działa diagnostyka oparta na AI
Diagnostyka predykcyjna to proces, a nie jednorazowa analiza. Przebiega w kilku krokach:
- Zbieranie danych - czujniki na maszynie przesyłają odczyty, a CMMS dostarcza historię awarii i napraw.
- Okres uczenia - algorytm poznaje normalną pracę konkretnej maszyny w różnych warunkach.
- Wykrywanie odchyleń - system porównuje bieżące odczyty ze wzorcem i szuka anomalii oraz narastających trendów.
- Alert - gdy odchylenie przekracza próg, dział utrzymania ruchu dostaje sygnał.
- Zlecenie i weryfikacja - serwis sprawdza maszynę, a wynik przeglądu wraca do danych i poprawia model.
Od intuicji operatora do algorytmu
Przejście od intuicji do algorytmów nie nastąpiło jednym skokiem. Kolejne etapy nie zastępowały poprzednich, tylko dokładały nowe źródła informacji:
| Etap | Na czym się opiera | Ograniczenie |
|---|---|---|
| Intuicja operatora | Słuch, dotyk, zapach, doświadczenie z konkretną maszyną | Wiedza w głowie jednej osoby, subiektywna ocena |
| Przeglądy okresowe | Harmonogram z dokumentacji producenta | Usterki między przeglądami pozostają niewykryte |
| Diagnostyka przyrządami | Okresowe pomiary drgań, termowizja, analiza oleju | Obraz stanu tylko w dniu pomiaru |
| Monitoring ciągły | Czujniki i progi alarmowe | Alarm dopiero po przekroczeniu wartości granicznej |
| Analiza AI | Wzorzec normalnej pracy wyuczony na danych | Wymaga historii odczytów i napraw |
Od zmysłów operatora do pomiarów
Większość sygnałów, na które reagował doświadczony pracownik, ma swój mierzalny odpowiednik:
- Stukot i metaliczne dźwięki - analiza akustyczna i pomiar drgań, które wskazują luzy oraz uszkodzenia łożysk.
- Pisk i gwizd - pomiar ultradźwięków, pomocny przy tarciu, braku smarowania i wyciekach sprężonego powietrza.
- Drgania wyczuwalne dłonią - czujnik drgań, który rejestruje zmiany amplitudy i częstotliwości.
- Ciepło obudowy - czujnik temperatury na silniku, przekładni lub łożysku.
- Zmiana pracy pod obciążeniem - pomiar prądu silnika, który ujawnia rosnące opory mechaniczne.
Różnica polega na czułości i ciągłości. Algorytm wychwytuje zmianę częstotliwości drgań na długo przed tym, zanim stanie się słyszalna, i robi to na każdej zmianie, także w nocy. Szczegóły metod analizy opisuje artykuł o sztucznej inteligencji w diagnozowaniu maszyn.
Granice intuicji
Doświadczenie operatora ma dużą wartość, ale jako jedyne źródło wiedzy o stanie maszyn zawodzi z kilku powodów:
- Wiedza odchodzi z pracownikiem - przejście na emeryturę lub zmiana pracy zabiera wiedzę o konkretnych maszynach.
- Hałas hali - wiele sygnałów ginie w tle innych urządzeń.
- Brak porównania - trudno ocenić, czy dźwięk jest głośniejszy niż miesiąc temu.
- Zmiany i obsada - na nocnej zmianie przy maszynie może nie być osoby, która zna jej brzmienie.
Metody AI w diagnostyce maszyn
Za skuteczną diagnostyką stoi kilka technik, a nie jeden uniwersalny algorytm.
| Metoda | Co wykrywa | Przykład |
|---|---|---|
| Uczenie maszynowe | Wzorzec normalnej pracy danej maszyny | Model uczony na historycznych odczytach z czujników |
| Analiza szeregów czasowych | Powolne, narastające trendy | Stopniowy wzrost temperatury łożyska na przestrzeni tygodni |
| Wykrywanie anomalii | Nagłe, pojedyncze odchylenia | Skok wibracji po nieprawidłowym montażu części |
Jakość modelu zależy od okresu uczenia. Zbyt krótki okres zbierania danych daje wiele fałszywych alarmów, które technicy zaczynają ignorować. Dlatego próg czułości zawęża się stopniowo, w miarę gromadzenia kolejnych cykli pracy maszyny. Mechanizm rozpoznawania wzorców opisuje artykuł od intuicji do algorytmów - jak AI nauczyła się słuchać maszyn.
Źródła danych - czujniki i sygnały
Im więcej niezależnych źródeł danych łączy system, tym trudniej o fałszywy alarm i tym wcześniej widać rzeczywisty problem.
| Źródło danych | Co mierzy | Jaką usterkę może zapowiadać |
|---|---|---|
| Czujnik drgań (akcelerometr) | Mikrodrgania łożysk i wałów | Zużycie łożyska, niewyważenie, luzy |
| Czujnik temperatury | Nagrzewanie silników, przekładni i łożysk | Przeciążenie, brak smarowania |
| Pomiar prądu silnika | Zmiany obciążenia elektrycznego | Problemy mechaniczne widoczne pośrednio, bez dostępu do wnętrza maszyny |
| Analiza dźwięku i ultradźwięków | Sygnały akustyczne pracy urządzenia | Wycieki sprężonego powietrza, tarcie w łożyskach |
| Historia z CMMS | Awarie, naprawy, zużyte części | Powtarzające się usterki danego typu maszyny |
Krzywa P-F, czyli skąd bierze się wyprzedzenie
Większość uszkodzeń mechanicznych nie pojawia się nagle, tylko narasta. W utrzymaniu ruchu opisuje to krzywa P-F: punkt P to moment, w którym usterkę da się już wykryć, a punkt F - moment, w którym maszyna przestaje spełniać swoją funkcję. Czas między nimi to interwał P-F, czyli okno na zaplanowanie naprawy.
Różne metody wykrywania trafiają w różne miejsca tej krzywej:
| Sposób wykrycia | Moment na krzywej P-F | Czas na reakcję |
|---|---|---|
| Analiza danych z czujników (AI) | Wczesne zmiany drgań, prądu lub ultradźwięków | Najdłuższy - naprawa w planowanym postoju |
| Okresowe pomiary diagnostyczne | Zmiany widoczne w dniu pomiaru | Zależy od odstępu między pomiarami |
| Objawy słyszalne i wyczuwalne | Hałas, wyczuwalne drgania | Krótki - trzeba działać szybko |
| Wzrost temperatury, dym, zapach | Tuż przed awarią | Minimalny |
| Awaria | Punkt F | Brak - naprawa w trybie awaryjnym |
AI nie wydłuża samego interwału P-F - przesuwa moment wykrycia bliżej punktu P. Im wcześniej padnie sygnał, tym więcej czasu na zamówienie części i uzgodnienie postoju z produkcją.
Utrzymanie reaktywne, prewencyjne i predykcyjne
| Parametr | Reaktywne | Prewencyjne | Predykcyjne (AI) |
|---|---|---|---|
| Moment interwencji | Po awarii | Wg harmonogramu | Na podstawie stanu maszyny |
| Ryzyko przestoju | Wysokie, nieplanowane | Średnie | Niskie, przewidywane z wyprzedzeniem |
| Koszt części | Wysoki - zakupy awaryjne | Średni - wymiana czasem zbyt wczesna | Niższy - wymiana w odpowiednim momencie |
| Nakłady wstępne | Minimalne | Niskie - harmonogram przeglądów | Czujniki, integracja i okres uczenia |
Od alertu do zlecenia w CMMS
Sam alert niczego nie naprawia. Wartość diagnostyki pojawia się dopiero wtedy, gdy sygnał zamienia się w zlecenie z terminem, wykonawcą i częściami. Tę rolę pełni system CMMS.

Moduł Naprawy grupuje zlecenia wg statusu: nowe, przyjęte, w realizacji, zrealizowane i anulowane. Zlecenie wynikające z diagnozy trafia do tego samego obiegu co zgłoszenie od operatora, więc serwis nie prowadzi dwóch osobnych list prac. Po zamknięciu zlecenia opis naprawy i zużyte części wracają do historii maszyny i uzupełniają dane, na których uczy się model.
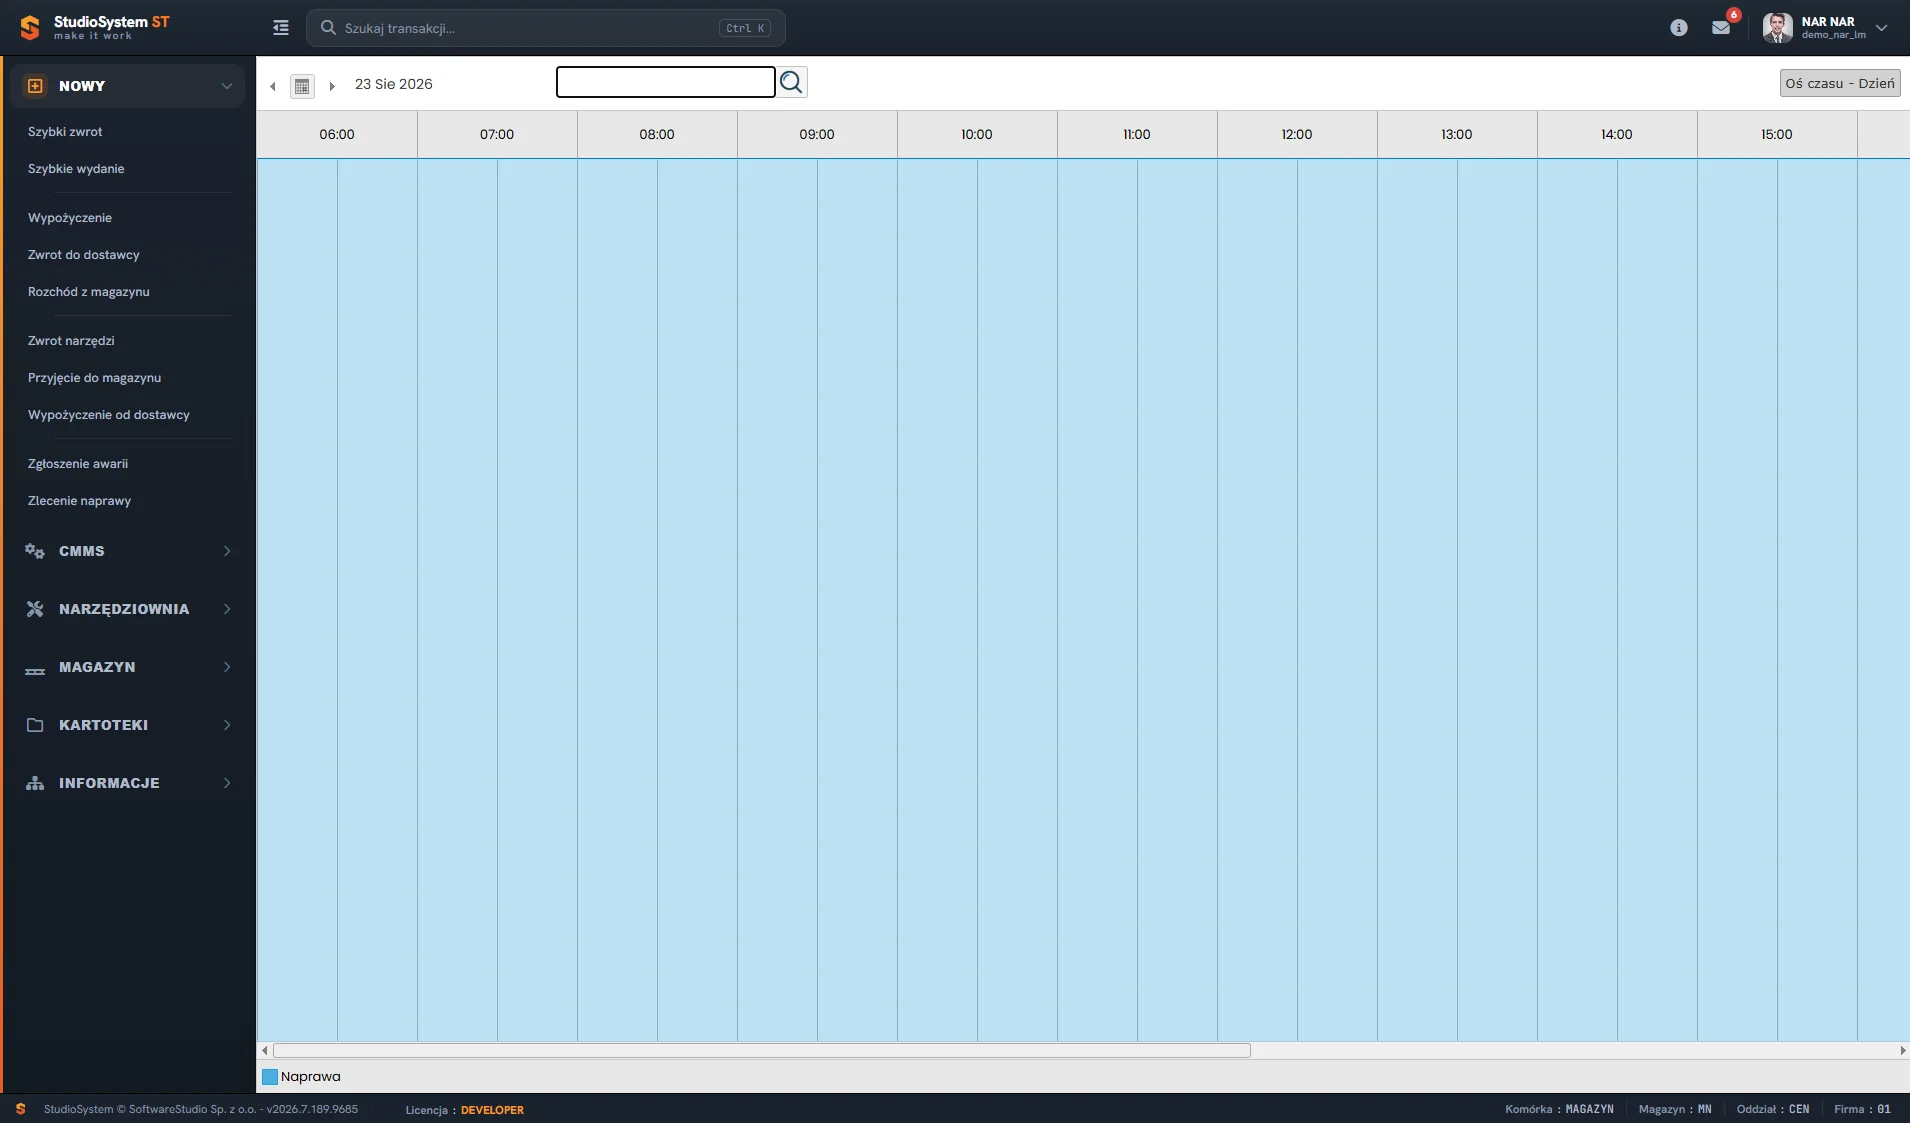
Prognoza daje czas na wybór terminu. Oś czasu pokazuje zlecenia w układzie godzinowym zmiany, więc naprawę wynikającą z diagnozy można wstawić w okno, w którym serwis jest wolny, a maszyna i tak ma zaplanowany postój. Integrację CMMS z systemami firmy opisuje strona system CMMS dla przemysłu.
Wynik alertu zapisany w zgłoszeniu

Żeby policzyć trafność, każdy alert musi zostawić ślad. Najprościej rejestrować go jako zgłoszenie awarii i zamykać z właściwym statusem: zrealizowane, gdy oględziny potwierdziły problem, lub anulowane, gdy go nie było. Lista zgłoszeń pokazuje status, datę zdarzenia, datę zgłoszenia, obiekt, rodzaj awarii i datę zamknięcia, więc po kilku miesiącach wystarczy zestawić zgłoszenia maszyn z pilotażu. Wysoki udział anulowanych oznacza zbyt czuły model, a awarie bez wcześniejszego zgłoszenia - zbyt mało czuły lub brak odpowiedniego czujnika.
Wiedza operatora zapisana w zgłoszeniu
Zanim algorytm nauczy się rozpoznawać usterki, ktoś musi je opisać. Najlepszym momentem na zapis wiedzy operatora jest zgłoszenie awarii.

Formularz zgłoszenia łączy obiekt, rodzaj awarii, status, osobę odpowiedzialną i informację o zatrzymaniu produkcji. Zakładki Uwagi, Dyskusja i Zdjęcia pozwalają zapisać to, co operator zauważył przed usterką - „od rana nierówny dźwięk”, „obudowa cieplejsza niż zwykle” - razem ze zdjęciem. Takie opisy, powiązane później z przyczyną ustaloną przy naprawie, pokazują, jakie objawy poprzedzają dany typ awarii. Jednolity słownik rodzajów awarii ułatwia późniejszą analizę.
Wzorce w historii awarii
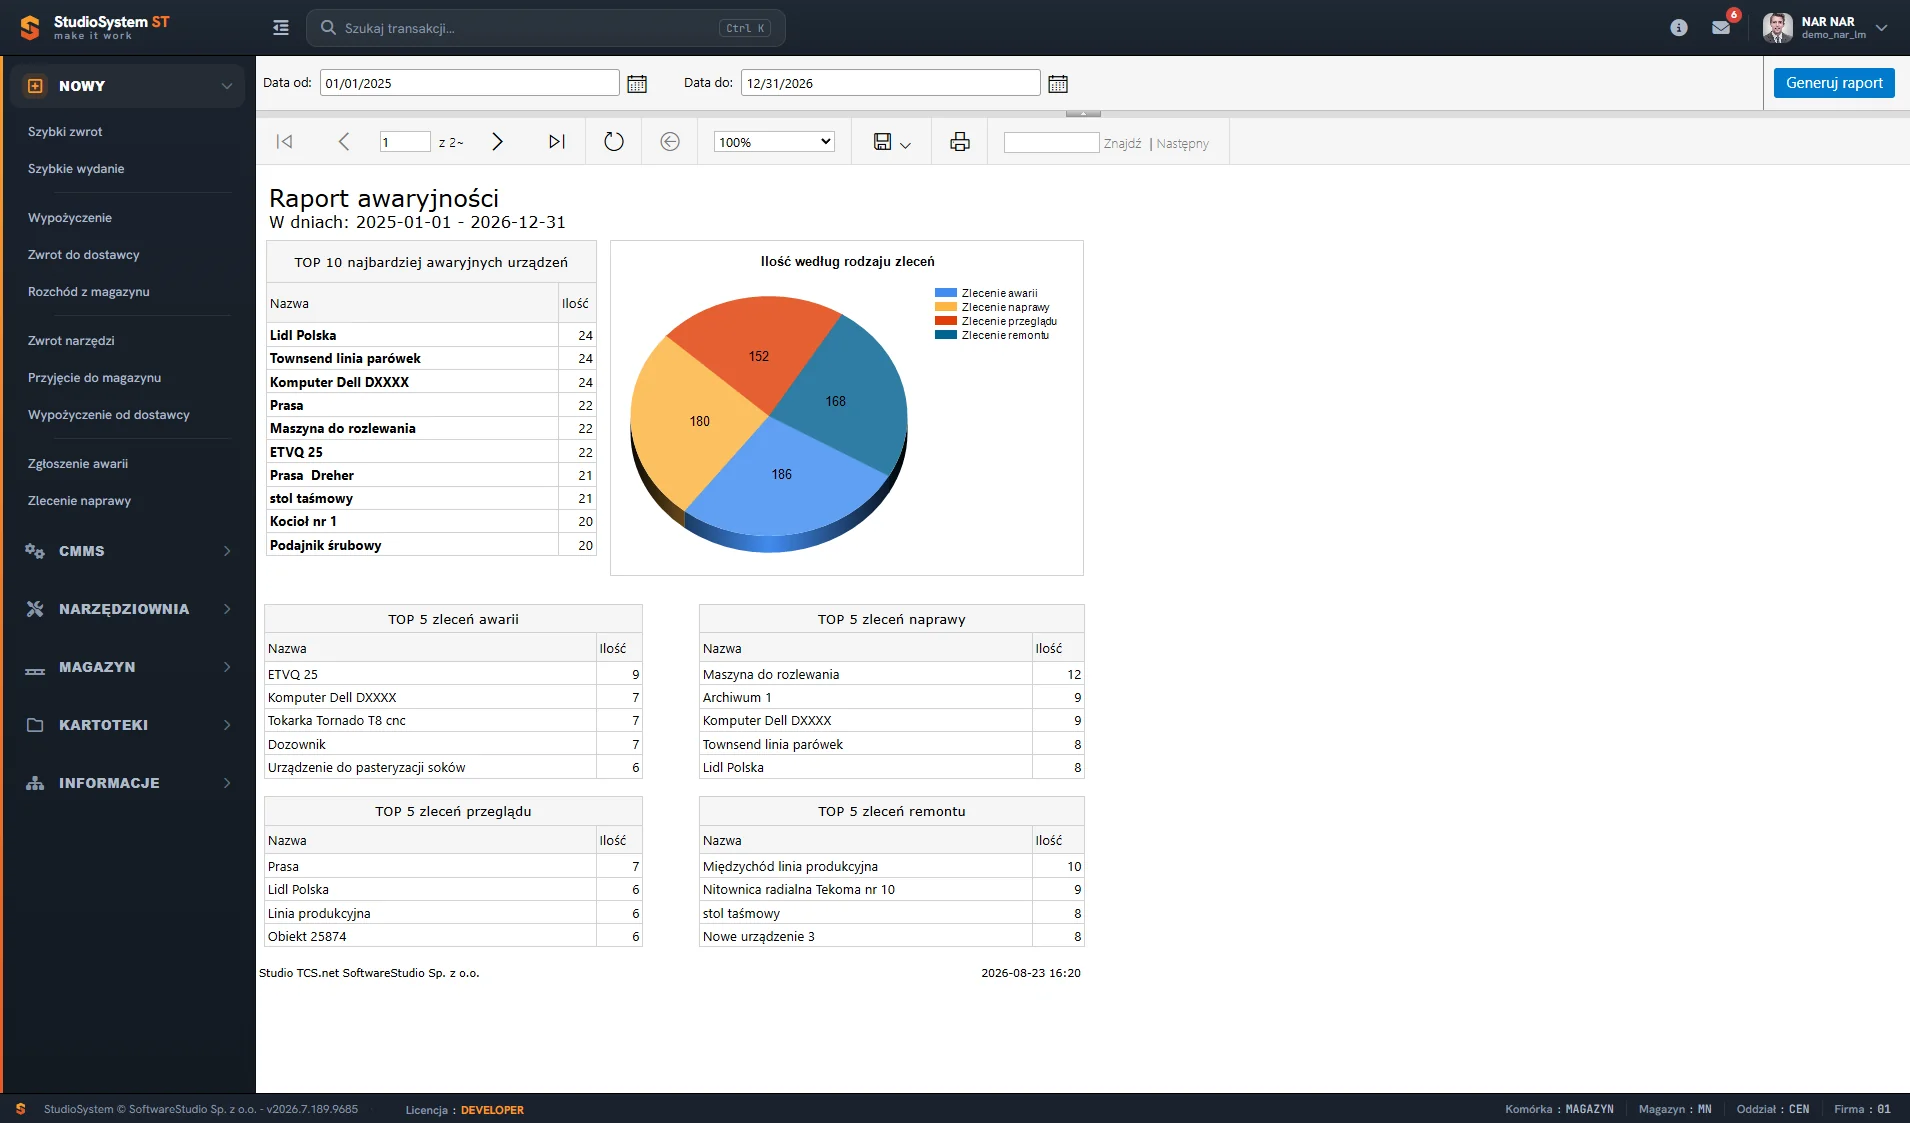
Raport awaryjności zestawia zgłoszenia w wybranym zakresie dat i wskazuje urządzenia, które najczęściej się psują. To, co doświadczony mechanik wiedział z pamięci - że prasa numer trzy co jesień ma problem z hydrauliką - staje się widoczne w danych dla każdego. Maszyny z czołówki raportu są naturalnymi kandydatami do montażu czujników i pilotażu analizy AI, bo tam jest najwięcej przypadków, na których model może się uczyć.
Człowiek i algorytm - podział ról
| Zadanie | Doświadczony pracownik | Algorytm AI |
|---|---|---|
| Wykrycie odchylenia | Gdy objaw jest wyczuwalny | Wcześnie, na podstawie ciągłych pomiarów |
| Interpretacja przyczyny | Oględziny, wiedza o maszynie i jej historii | Wskazanie prawdopodobnego typu usterki |
| Decyzja o zatrzymaniu | Tak, uwzględnia produkcję i bezpieczeństwo | Nie, dostarcza przesłanki |
| Opis objawów | Źródło danych do nauki modelu | Korzysta z opisów zapisanych w zgłoszeniach |
| Praca na wszystkich zmianach | Zależy od obsady | Tak, niezależnie od pory |
Przykładowe scenariusze
Obrabiarki CNC
Wyobraźmy sobie zakład obróbki metali z kilkudziesięcioma obrabiarkami CNC, w którym najdroższe są nieplanowane awarie wrzecion. Wdrożenie diagnostyki mogłoby przebiegać tak:
- Czujniki - drgania i temperatura mierzone na wrzecionach maszyn krytycznych.
- Uczenie - przez kilka tygodni system buduje wzorzec normalnej pracy każdego wrzeciona.
- Pierwsze sygnały - system wykrywa stopniowy wzrost wibracji jednego wrzeciona, jeszcze niewyczuwalny dla operatora.
- Zlecenie - serwis planuje przegląd, a magazyn przygotowuje łożysko.
- Wymiana w planowanym postoju - zamiast wielogodzinnego przestoju w środku zmiany.
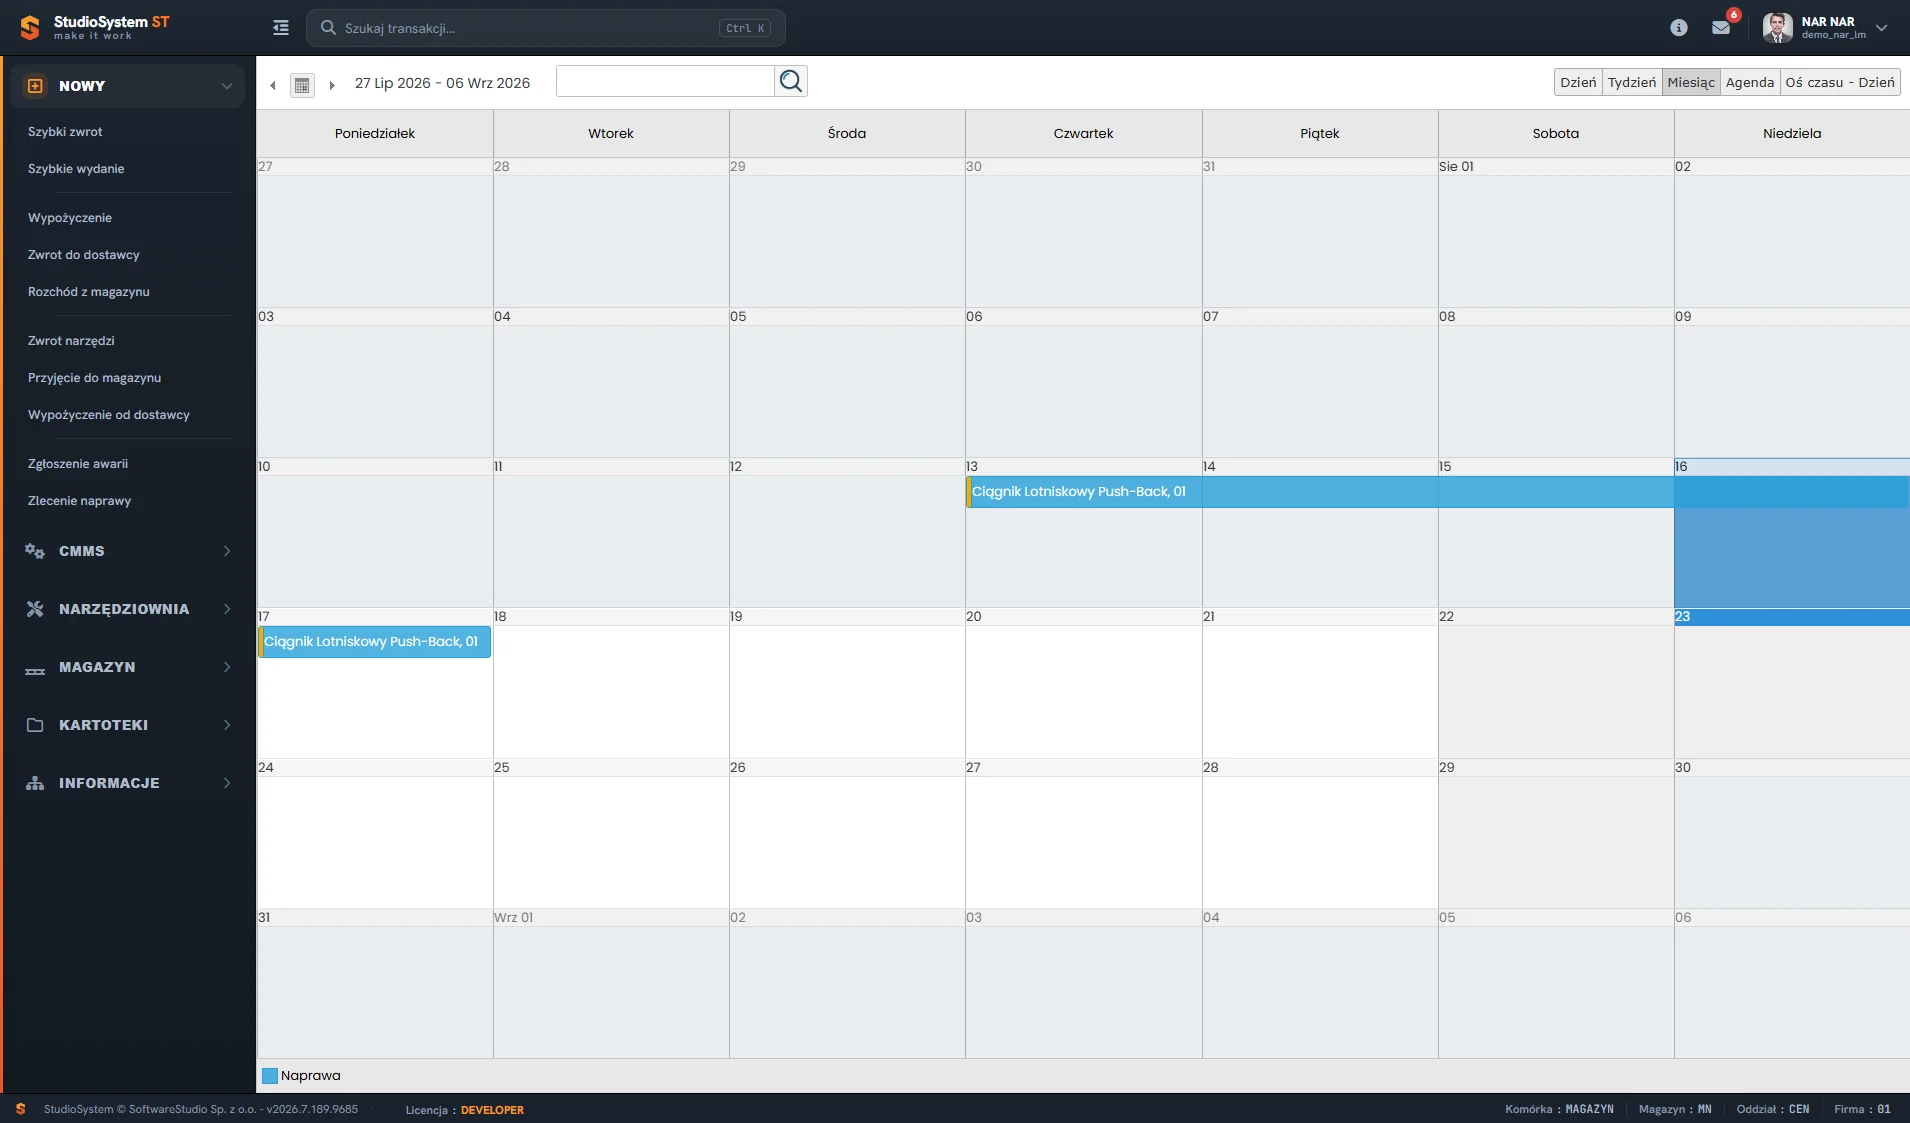
Kalendarz zleceń w widoku miesięcznym pozwala zobaczyć, gdzie w planie jest miejsce na taką wymianę. Prace trwające kilka dni widać jako ciągły pasek, a przełącznik widoków - dzień, tydzień, miesiąc, agenda i oś czasu - pozwala przejść od planu miesięcznego do rozpisania prac na zmianę. Inne scenariusze opisuje artykuł technologia predykcyjna i optymalizacja procesów z AI.
Wentylator wyciągowy
Wyobraźmy sobie zakład, w którym jeden z mechaników od lat rozpoznaje po dźwięku zużycie łożysk w wentylatorach wyciągowych. Przejście od intuicji do danych mogłoby wyglądać tak:
- Każde jego zgłoszenie zawiera opis dźwięku, zdjęcie i rodzaj awarii, a zlecenie naprawy - potwierdzoną przyczynę.
- Po roku raport awaryjności pokazuje, że wentylatory odpowiadają za dużą część zgłoszeń na wydziale.
- Na trzech z nich montuje się czujniki drgań, a zapisane przypadki pomagają ocenić, jakie zmiany poprzedzały usterkę.
- Po okresie uczenia analiza wskazuje narastające drgania łożyska kilka tygodni przed tym, jak zmiana staje się słyszalna.
- Mechanik potwierdza diagnozę przy oględzinach, a wymiana łożyska trafia do planowanego postoju.
Wiedza jednej osoby nie znika - zostaje zapisana w historii maszyn i pracuje także wtedy, gdy tej osoby nie ma na zmianie. Szerszy kontekst predykcji w utrzymaniu ruchu przedstawia artykuł AI w zarządzaniu utrzymaniem ruchu, a ewidencję narzędzi potrzebnych do napraw prowadzi Narzędziownia - program do zarządzania i ewidencji narzędzi.
Jak mierzyć skuteczność diagnostyki AI
Ocena „system chyba pomaga” nie wystarczy do decyzji o rozszerzeniu wdrożenia. Warto od początku zbierać kilka mierników:
| Miernik | Co pokazuje | Skąd dane |
|---|---|---|
| Trafność alertów | Jaka część ostrzeżeń potwierdziła się przy oględzinach | Zgłoszenia zrealizowane a anulowane |
| Awarie niewykryte | Ile usterek wystąpiło bez wcześniejszego ostrzeżenia | Zgłoszenia awarii bez poprzedzającego alertu |
| Wyprzedzenie | Ile dni minęło od alertu do potwierdzonej usterki | Daty alertu i zgłoszenia lub naprawy |
| Dni przestoju | Czy maszyny objęte pilotażem stoją krócej | Raport ciągłości prac |
| Koszt napraw | Czy spada udział napraw awaryjnych i drogich części | Raport napraw z częściami |
Przestoje przed i po pilotażu
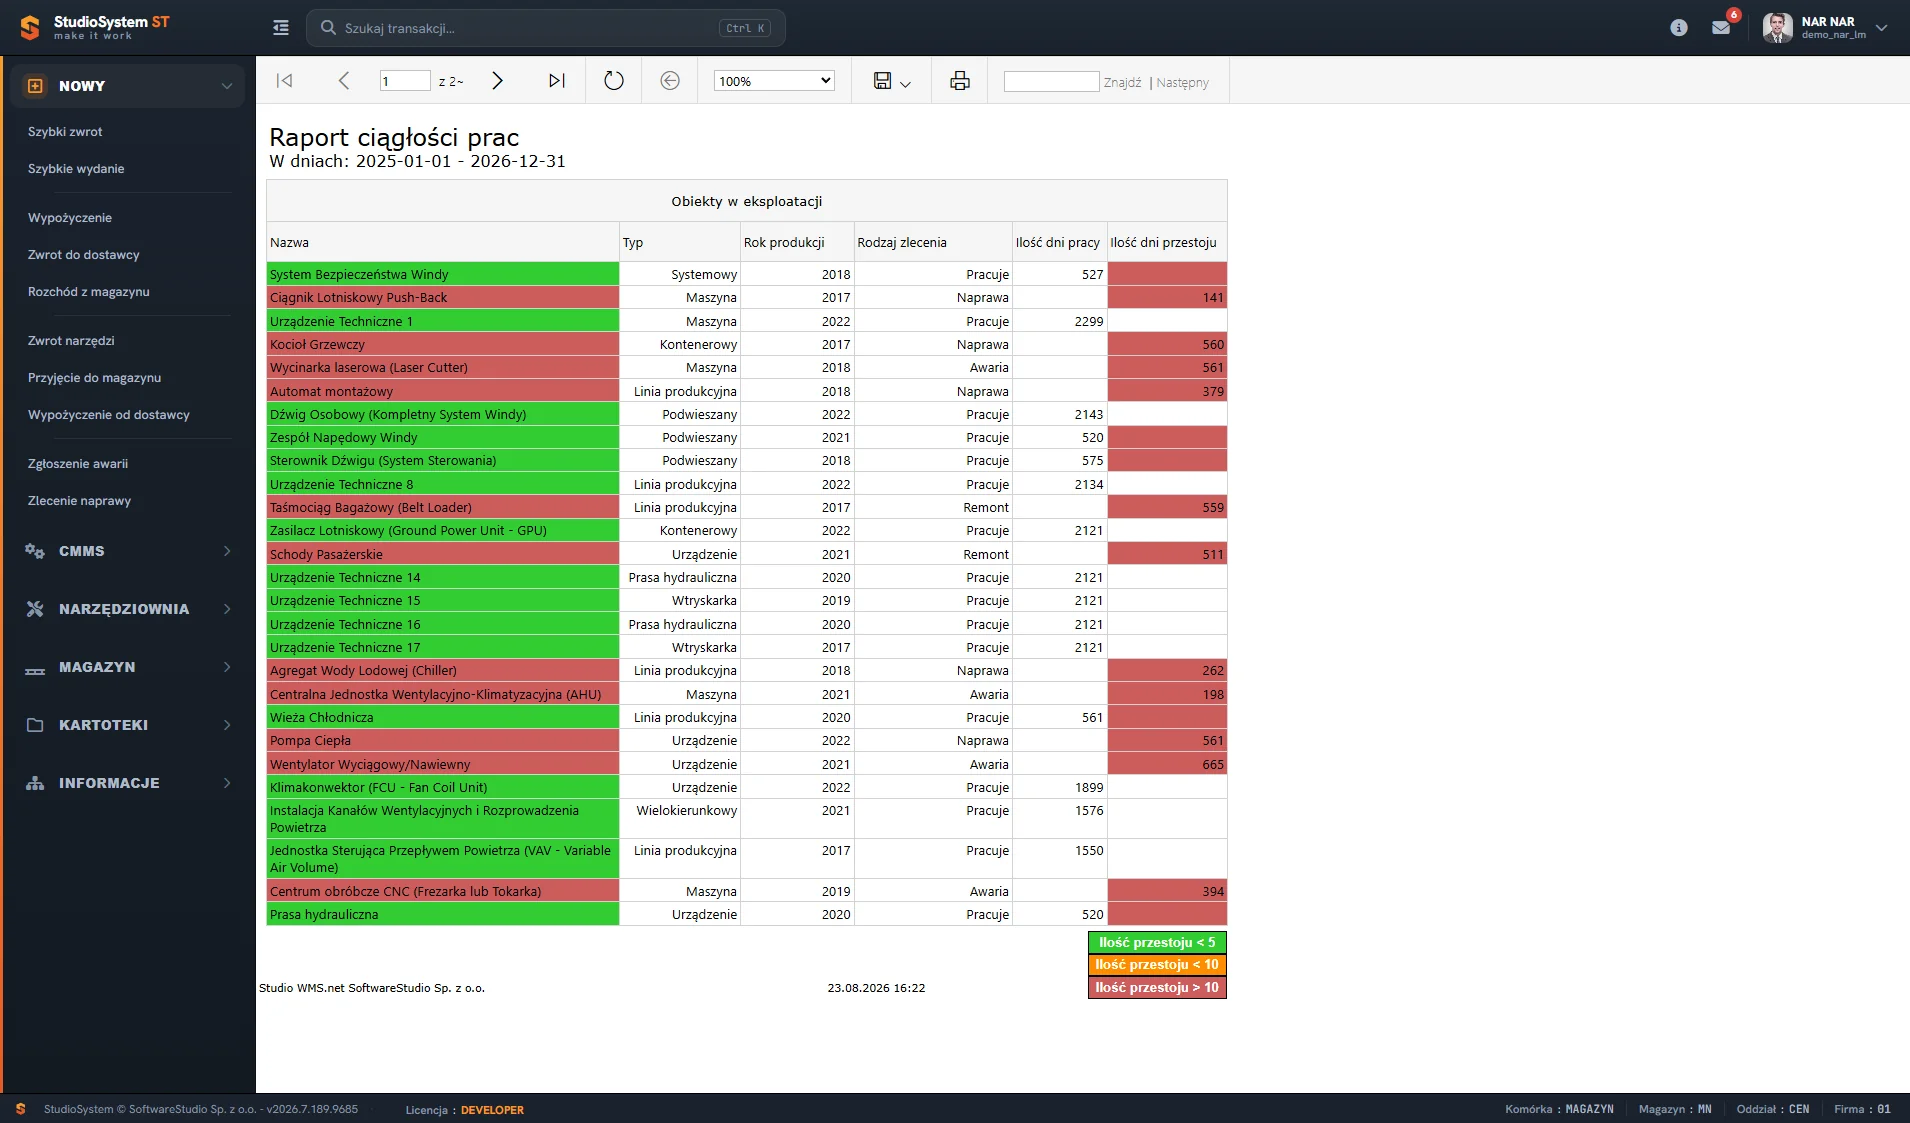
Raport ciągłości prac zestawia dla każdego obiektu liczbę dni pracy i dni przestoju w wybranym zakresie dat. Porównanie tego samego okresu przed i po uruchomieniu predykcji - dla maszyn objętych pilotażem i dla podobnych maszyn bez niego - daje najuczciwszy obraz efektu. Grupa porównawcza jest ważna, bo przestoje zmieniają się też z innych powodów, np. obciążenia produkcji. Sposób liczenia wskaźnika opisuje artykuł o dostępności technicznej maszyn.
Koszt napraw i części
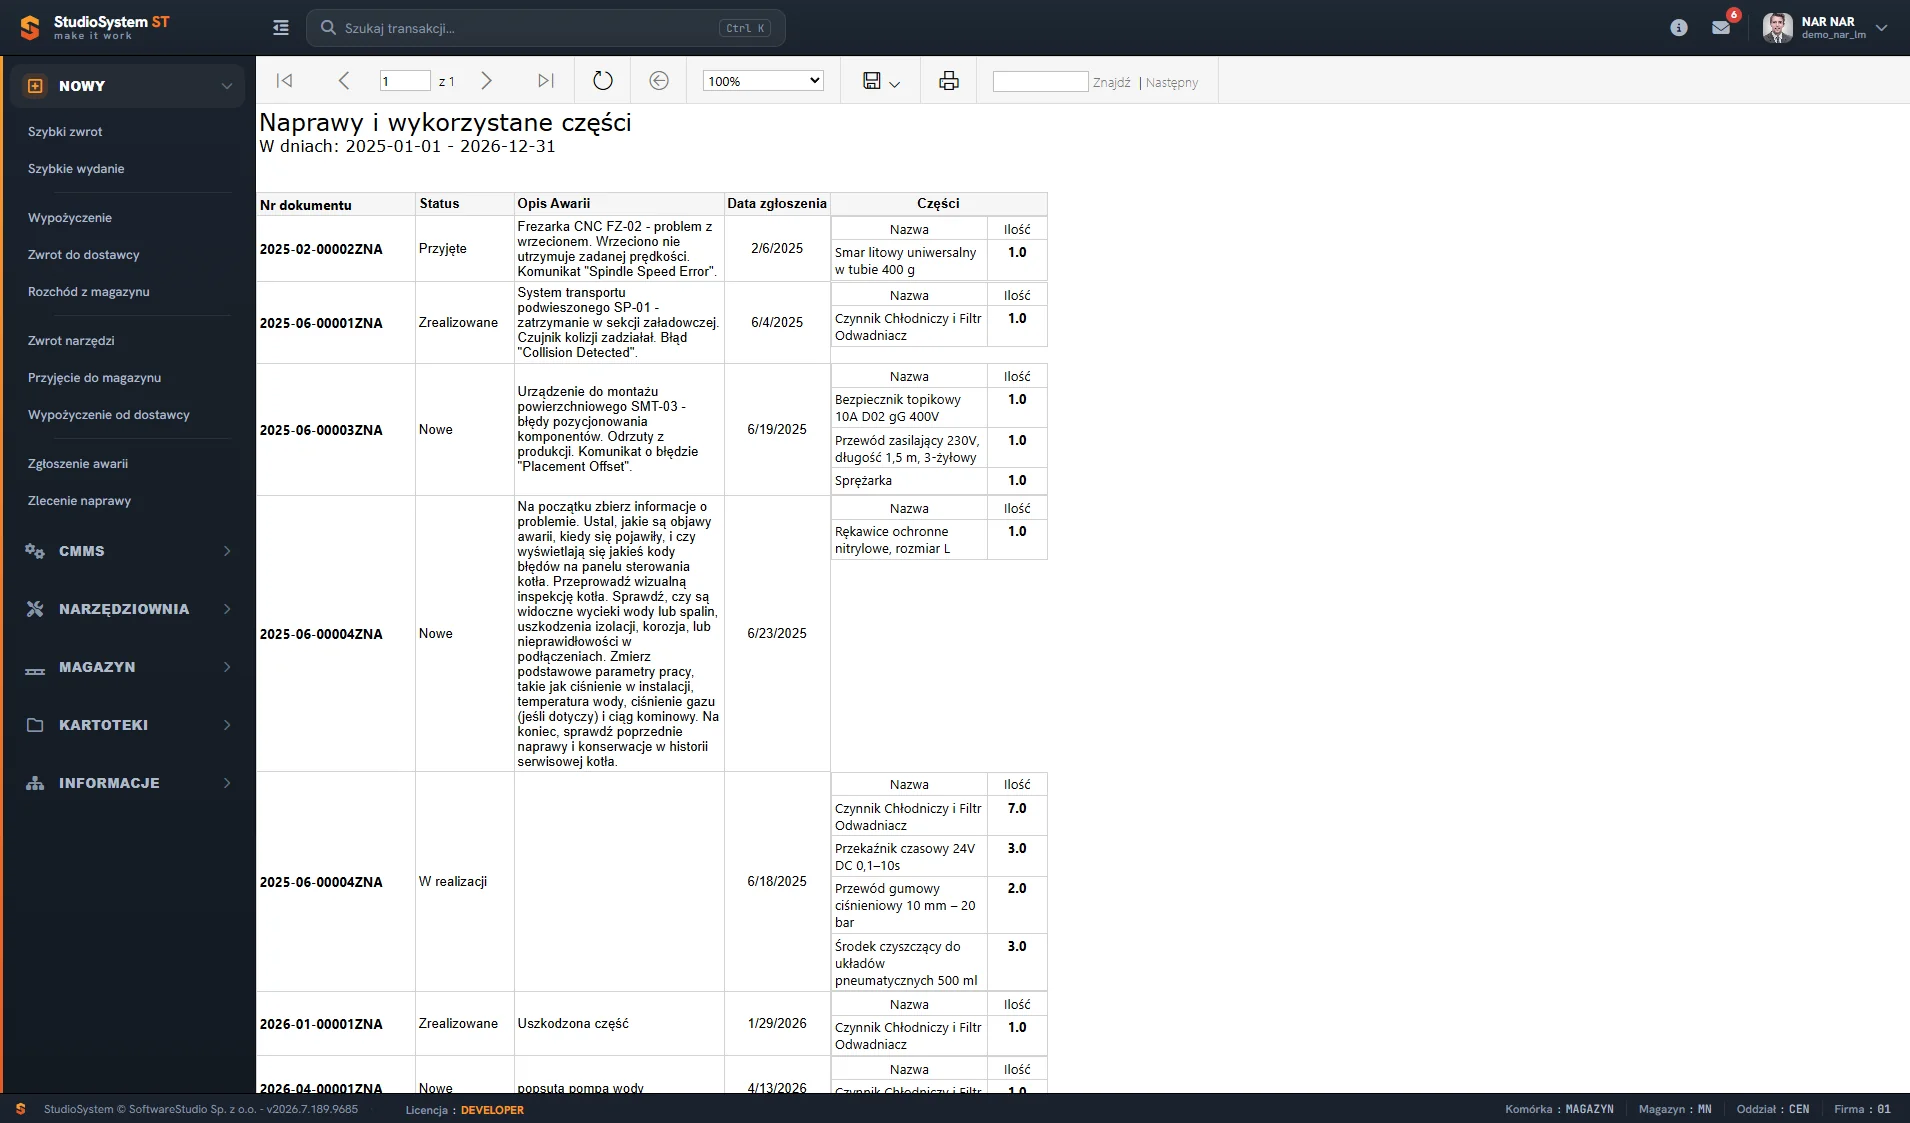
Raport napraw z częściami pokazuje dla każdego zlecenia opis awarii, datę zgłoszenia i listę zużytych części z ilościami - na zrzucie np. naprawę wrzeciona frezarki CNC. Usterka wykryta wcześnie zwykle kończy się wymianą jednego elementu, a ta sama usterka doprowadzona do awarii potrafi uszkodzić kolejne podzespoły. Porównanie list części przy naprawach planowanych i awaryjnych pokazuje ten efekt w liczbach własnego zakładu. Organizację zapasu części opisuje artykuł o magazynie części zamiennych MRO.
Co jest potrzebne do wdrożenia
- Czujniki i łączność - odczyty przekazywane w formacie, który da się zintegrować, oraz sieć między maszynami a serwerem.
- Historia w CMMS - uporządkowane zgłoszenia awarii i napraw, najlepiej z kilkunastu miesięcy.
- Okres uczenia - zależnie od liczby i zmienności maszyn od kilku do kilkunastu tygodni.
- Integracja - wymiana danych przez REST API z istniejącą infrastrukturą.
- Procedura reakcji - kto odbiera alert, w jakim czasie i jak decyduje o zleceniu.
Szerszy kontekst i ograniczenia AI opisuje artykuł AI w zarządzaniu utrzymaniem ruchu, a przykłady z praktyki - AI w diagnozowaniu maszyn. CMMS z predykcją awarii AI jest częścią pakietu Enterprise opisanego w cenniku.
Przebieg pilotażu
- Wybór maszyn - kilka urządzeń z usterkami narastającymi i dużym wpływem na produkcję, najlepiej z podobnymi maszynami do porównania.
- Punkt odniesienia - dni przestoju, liczba awarii i koszt napraw z okresu przed pilotażem.
- Zasady obsługi alertów - kto ocenia sygnał, kiedy zakłada zgłoszenie i jak je zamyka.
- Okres uczenia - czas, w którym model poznaje normalną pracę maszyn, a alerty traktuje się ostrożnie.
- Ocena - trafność, awarie niewykryte, wyprzedzenie, przestoje i koszty po kilku miesiącach.
- Decyzja - rozszerzenie na kolejne maszyny, zmiana czujników albo rezygnacja tam, gdzie predykcja się nie sprawdza.
Ograniczenia diagnostyki AI
- Mała liczba zdarzeń - maszyna, która psuje się raz na kilka lat, daje modelowi niewiele materiału do nauki.
- Zmiana warunków pracy - nowy asortyment lub inne obciążenie zmienia wzorzec i wymaga ponownego uczenia.
- Czujniki i integracja - bez danych z maszyny analiza opiera się tylko na historii zgłoszeń i napraw.
- Przeglądy obowiązkowe - predykcja nie zastępuje przeglądów wymaganych przepisami ani badań UDT.
- Decyzja człowieka - alert jest przesłanką, a o zatrzymaniu maszyny decyduje osoba odpowiedzialna.
W Studio TCS.net CMMS z predykcją awarii AI należy do pakietu Enterprise opisanego w cenniku. Obsługę alertów w codziennej pracy opisuje artykuł o monitorowaniu pracy maszyn z AI, a zapis wiedzy doświadczonych mechaników - tekst od intuicji do algorytmów. Ewidencję narzędzi potrzebnych do napraw prowadzi Narzędziownia - program do zarządzania i ewidencji narzędzi.
Nie każdą usterkę da się przewidzieć
Wyprzedzenie zależy od tego, jak rozwija się dana usterka:
- Zużycie łożysk, niewyważenie, luzy - narastają stopniowo i dają wyraźny sygnał w drganiach, więc dobrze nadają się do predykcji.
- Problemy smarowania i chłodzenia - widoczne w temperaturze i prądzie silnika, zwykle z wyprzedzeniem.
- Degradacja izolacji i styków - wykrywalna pomiarami elektrycznymi, ale wymaga odpowiednich czujników.
- Uszkodzenia elektroniki - często nagłe, z niewielkim lub żadnym okresem ostrzegawczym.
- Błędy obsługi i uszkodzenia mechaniczne z zewnątrz - praktycznie nieprzewidywalne na podstawie trendów.
Dlatego predykcję stosuje się tam, gdzie dominują usterki narastające, a przeglądy i zabezpieczenia pozostają dla pozostałych.